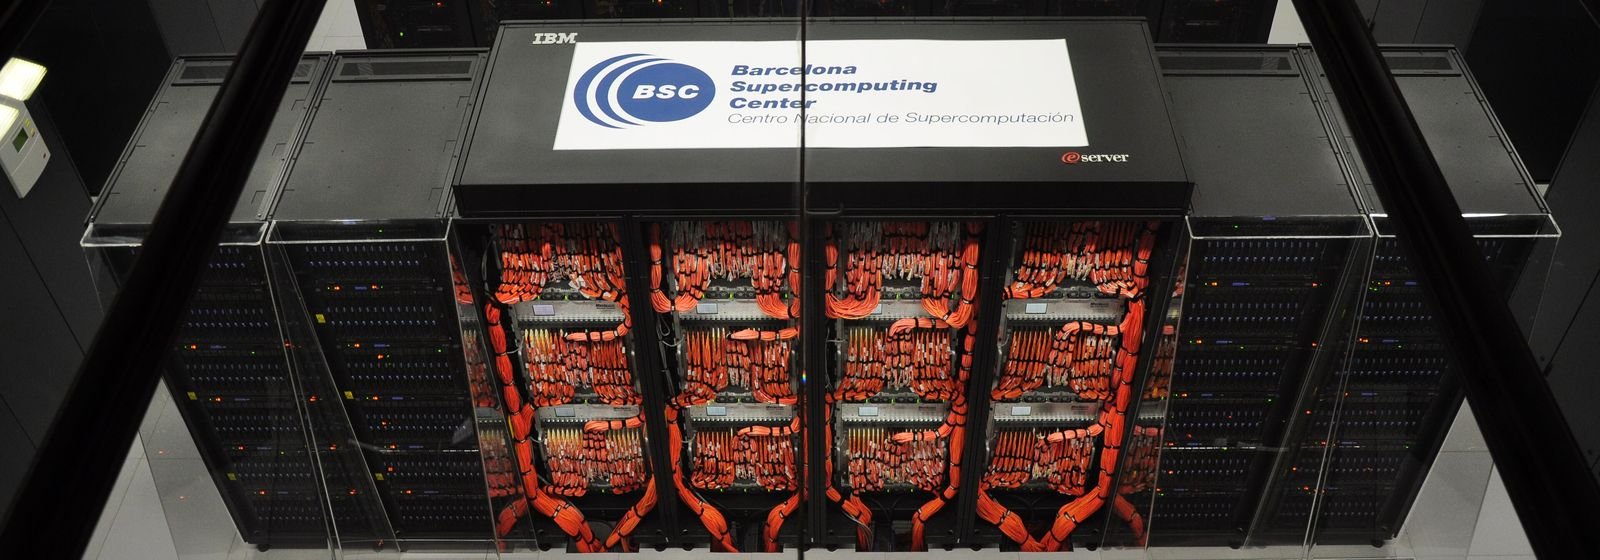
Bioinformática y genómica computacional
Bases de datos, formatos, algoritmos y herramientas para analizar secuencias y genomas
En una frase: la bioinformática aplica la informática y la estadística a los datos biológicos; sin ella sería imposible leer, comparar e interpretar los millones de secuencias que produce un laboratorio moderno.
Las bases de datos, los formatos, los algoritmos y las herramientas para analizar secuencias y genomas. Cada ventana resume un concepto en pocas líneas y, cuando publiquemos su artículo, te llevará a la explicación completa.
Para empezar
Paso 1Los conceptos clave de esta área, explicados desde cero.
Qué es la bioinformática
La disciplina que desarrolla y usa programas, bases de datos y métodos estadísticos para analizar datos biológicos, desde una sola secuencia hasta miles de genomas.
Artículo completo próximamenteBases de datos: NCBI, Ensembl y UCSC
Los grandes portales públicos de secuencias y anotaciones. GenBank, del NCBI, guarda secuencias de todo el mundo; Ensembl y el navegador UCSC permiten explorar genomas con sus genes, variantes y elementos reguladores.
Artículo completo próximamenteFormatos: FASTA, FASTQ, SAM/BAM y VCF
FASTA guarda secuencias; FASTQ, lecturas de secuenciación con la calidad de cada letra; SAM y BAM, lecturas alineadas contra un genoma; y VCF, las variantes encontradas.
Artículo completo próximamentePara profundizar
Paso 2Cómo funciona por dentro y qué matices conviene conocer.
Control de calidad de lecturas
Antes de analizar se revisa la calidad de las lecturas, se recortan adaptadores y bases de mala calidad y se buscan contaminaciones. Herramientas como FastQC resumen estos datos.
Artículo completo próximamenteAlineamiento y mapeo
Colocar cada lectura en su posición del genoma de referencia. Programas como BWA-MEM o minimap2 lo hacen con millones de lecturas usando índices que aceleran la búsqueda.
Artículo completo próximamenteLlamada de variantes
Detectar dónde las lecturas alineadas difieren de la referencia y decidir si es una variante real o un error. GATK y DeepVariant están entre las herramientas más usadas.
Artículo completo próximamenteAnotación de variantes
Añadir a cada variante su información: en qué gen cae, qué efecto tiene en la proteína y con qué frecuencia aparece en la población. VEP y ANNOVAR son herramientas habituales.
Artículo completo próximamentegnomAD, ClinVar y dbSNP
gnomAD recoge la frecuencia de variantes en cientos de miles de personas; ClinVar, cómo han clasificado los laboratorios cada variante; dbSNP asigna los identificadores rs a las variantes conocidas.
Artículo completo próximamentePara especialistas
Paso 3El detalle técnico que se usa en investigación y en la clínica.
Ensamblaje de novo
Reconstruir un genoma sin referencia previa, uniendo lecturas que se solapan. Las lecturas largas han hecho posible ensamblar genomas casi completos de muchas especies.
Artículo completo próximamenteFilogenética computacional
Reconstruir árboles evolutivos a partir de secuencias con métodos de máxima verosimilitud o bayesianos. Se usa desde la evolución de las especies hasta el seguimiento de brotes de virus.
Artículo completo próximamenteProgramar en genómica: Python, R y Bioconductor
Python y R son los lenguajes más usados, y la línea de comandos de Linux es la herramienta diaria. Bioconductor reúne más de dos mil paquetes de R para análisis genómico.
Artículo completo próximamenteFlujos de trabajo: Nextflow y Snakemake
Encadenan los pasos de un análisis de forma reproducible y escalable, del control de calidad a la llamada de variantes. Comunidades como nf-core comparten flujos revisados y listos para usar.
Artículo completo próximamenteContenedores, HPC y nube
Los contenedores, como Docker o Apptainer, empaquetan el software con sus dependencias para que un análisis dé el mismo resultado en cualquier ordenador. Los grandes análisis corren en supercomputadores o en la nube.
Artículo completo próximamenteInteligencia artificial en genómica
Modelos de aprendizaje profundo que predicen la estructura de las proteínas, como AlphaFold (Nobel de Química de 2024), el efecto de las variantes o la actividad de regiones del ADN a partir de su secuencia.
Artículo completo próximamenteSigue aprendiendo
Continúa por el área siguiente del mapa o vuelve al índice de todas las áreas.
Preguntas frecuentes
Para análisis serios, sí: lo básico de Linux y de Python o R. Para empezar hay herramientas con interfaz gráfica, como Galaxy.
En clínica se usa sobre todo GRCh38, y aún GRCh37 en algunos laboratorios; el genoma completo T2T-CHM13 se va incorporando en investigación.
Hay materiales gratuitos de comunidades como Galaxy Training Network o Bioconductor, y en España varias universidades ofrecen másteres específicos.
Fuentes
Imagen de cabecera: Vcarceler, Wikimedia Commons (CC BY-SA 3.0), recortada.